


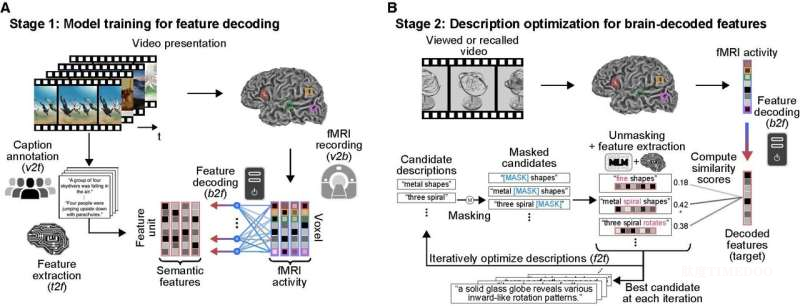
Science Advances 近日发表的一项研究,展示了一种能够从人脑活动中“读出”所见场景并生成文字描述的新技术,被研究团队称为“mind-captioning”(思维字幕化)方法。这一成果为理解人类复杂的思维表征和实现非语言者的沟通提供了新的可能。
从“词语匹配”到“场景描写”
过去的脑机接口或脑信号解码研究,多聚焦于识别单个词语、图像或语音对应的脑活动模式。有的研究尝试借助深度神经网络或图像字幕数据库,将脑信号与特定词汇匹配,但往往受限于词库覆盖范围,或在生成内容时引入了原始脑信号中并不存在的信息。
相比之下,这项新研究提出的“mind-captioning”方法,首次实现了通过大语言模型与脑活动的特征对齐,生成结构化、连贯的视觉场景描述。
研究团队利用了一种迭代优化过程(iterative optimization process):通过一个masked language model(MLM,掩码语言模型)不断调整生成文本,使其在语义空间中与从脑活动中解码出的特征更为接近。具体而言,他们使用了线性模型从功能磁共振成像(fMRI)数据中提取语义特征,并与深度语言模型的语义向量对应,最终由RoBERTa-large模型输出文本描述。
“看到什么,就能写出来”
实验中,6名受试者观看了共计2196段短视频,这些视频包含各种物体、场景、动作与事件。研究者同时采集其脑部fMRI活动信号。
这些视频此前已由其他观众进行众包式字幕描述,经过DeBERTa-large语言模型提取特征后,与受试者脑信号进行匹配。
研究人员指出,初始生成的文字往往零散且不成句意,但经过多轮优化后,系统逐渐生成了结构清晰、语义连贯的文本,能够准确反映受试者所观看视频的核心内容,甚至能捕捉场景中动态变化的细节。
值得注意的是,即使在某些具体物体识别不准确的情况下,模型仍能生成正确的“交互关系”描述。例如,当未能识别出“球”和“狗”时,模型仍会描述为“有两个物体在互动”,体现了其对高层语义结构的捕捉能力。
最终结果显示,该系统在视频字幕生成准确率上达到约50%,超过了现有同类方法的表现,并具备进一步提升的潜力。
从视觉到记忆:解码“回忆中的画面”
研究团队进一步让同一批受试者在未观看视频的情况下回忆之前的内容,并记录fMRI信号,以检验模型是否能够“读出记忆”。
结果显示,系统生成的描述与受试者回忆的视频内容高度相符,在100个候选视频中识别准确率最高可达40%。这意味着模型不仅能“看到”当下的视觉体验,还能一定程度上重构人脑中的记忆画面。
为失语者带来希望,也引发伦理思考
对于因中风或神经疾病而失去语言能力的人群,这项技术的潜在应用意义重大。与以往只能识别单词或简单图像的脑机接口不同,这一模型能捕捉更深层次的语义与概念关系,有望帮助患者恢复更自然、完整的表达能力。
然而,研究者也强调,“读心”技术的发展必须伴随严格的伦理框架。隐私保护与知情同意将成为未来应用的核心议题。如何防止个人脑数据被滥用,如何确保个体对自身“思维数据”的控制权,是这一领域亟需讨论的问题。
研究团队在论文中写道:“我们的方法在可解释性、泛化性与性能之间取得平衡,建立了一个透明的脑活动到语言的解码框架,为系统性研究人类大脑中语义表征的结构化编码方式铺平了道路。”
参考文献:Tomoyasu Horikawa, Mind captioning: Evolving descriptive text of mental content from human brain activity, Science Advances (2025). DOI: 10.1126/sciadv.adw1464
编辑:王洪
排版:李丽















评论 (0)