
人脑怎样处理和表征口语,一直是神经科学家想弄明白的事。听懂一个词,不像听出一串声音那么简单——大脑还得破译词的意思,以及这个意思如何随语境变来变去。
大语言模型(large language models, LLMs,也就是支撑 ChatGPT、Gemini 这类对话系统的 AI)的出现,给语言研究开了条新路。比如,把模型表征词义的方式,跟人听口语时记录的脑活动模式摆在一起比,就有可能看清大脑和 LLM 各自是怎么理解不同语境里的词的。
贝勒医学院(Baylor College of Medicine)、莱斯大学(Rice University)、加州大学伯克利分校(University of California, Berkeley)和得克萨斯儿童医院(Texas Children's Hospital)的研究者,就受了 LLM 处理语言的启发,研究成组的脑细胞如何编码词义。论文发表在 Nature Neuroscience 上,结论是:词义由海马体(hippocampus)——一个与记忆有关的脑区——中散布于多个神经元(nerve cells)的活动模式来表征。
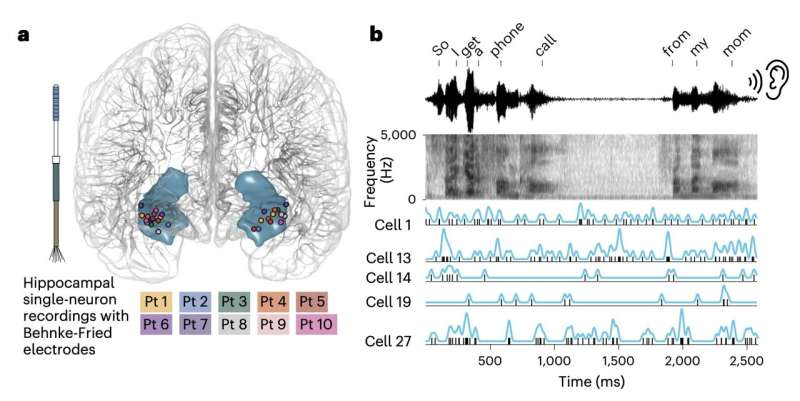
为了弄清大脑怎么编码词义,研究者先记录了 10 名受试者在听故事时海马体单个神经元的活动。记录用的是一根根微小金属丝电极,这些电极是因为癫痫的临床监测需要,才被植入受试者脑中的。
接着,团队用数学模型去分析故事里用到的语言和脑活动记录,借此检验:关于词义的信息,能不能预测出记录到的神经元活动。
"我们记录了受试者听叙事性言语时海马神经元的反应,"Melissa Franch 及同事在论文中写道,"用编码模型(encoding model)的方法,我们发现语义(semantics) 得到了稳健的编码,即便在控制音位(phonemics)和语法(grammar)之后也是如此。单个词具有复杂的选择性,涵盖多个语义范畴中的多个词。"
研究者想确定,究竟是哪些词、哪些语义(也就是与意义相关的)范畴,对应着海马体单个神经元的反应。他们还把成对词语引发的群体活动模式差异,与这些词词义之间的差异作了对比。
最后,研究者把记录到的脑活动,同语言模型处理相同故事时生成的数值化词表征作比较;也考察了 LLM 导出的多义性(polysemy) 度量——即一个词拥有多个相关义项的程度——与神经活动变化之间的关联有多强。
"和 LLM 里的嵌入向量(embedding vectors) 一样,神经群体反应之间的距离,与语义距离相关,"作者写道,"对于语义相近的词,即便是上下文嵌入器(contextual embedders),也显示出语义距离与神经距离之间的负相关;我们把这一模式归因于对比编码(contrastive coding) 带来的降噪益处。最后,神经群体活动与 GPT-2 嵌入对齐得最紧密,反应模式的变化也与 LLM 导出的多义性度量相关,说明语义编码在很大程度上是语境化的。"
用 LLM 反过来启发神经科学研究
这些结果说明,词义是在海马体的成群细胞之间表征的。具体来说,团队发现,成组海马神经元合并起来的活动模式,似乎携带着关于词义之间关系、以及这些词义如何随语境变化的信息。
"这些结果为理解海马神经元在听语言时如何编码词义,提供了一个神经计算层面的解释(neurocomputational account),"作者写道。
这项工作有助于理解海马体如何表征口语的意义。未来,它也可能启发更多研究,用 LLM 去探究大脑怎样处理语言。
参考文献:Melissa Franch et al, A population code for semantics in human hippocampus, Nature Neuroscience (2026). DOI: 10.1038/s41593-026-02436-4
编辑:周敏
排版:李丽


评论 (0)