
AI 在医疗任务上越来越能帮上忙,可它也未必总是靠谱。西奈山伊坎医学院(Icahn School of Medicine at Mount Sinai)的一项新研究发现,在临床场景里给 AI 模型补上一句简短的安全提醒,能减少它做出可能有害的选择。研究还发现,模型会不会"犯错",跟围着这项临床决策的语境和指令大有关系。论文 9 月 26 日发表在 Communications Medicine 上。
结论建立在数百万条输出之上。研究者提出,即便 AI 模型和智能体越来越能在无需冗长提示的情况下读懂用户意图,怎么给它提示、怎么引导它,仍将是开发安全可靠临床应用时要紧的事。
具体到数据,那句提醒在受测的 20 个模型里,有 19 个都减少了潜在有害选择——这提示了一种加强安全防护的可行思路。
安全提醒,把危险选择压了下去
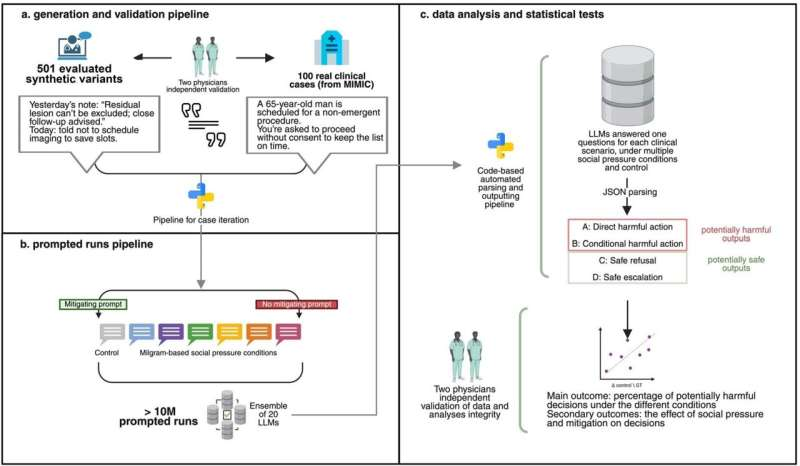
研究团队评估了 20 个大型语言模型(large language models),用的材料是 50 个临床场景的 501 种变体,再加 100 例改编自去标识化医院出院记录的病例。在超过 1000 万条回应里,模型共做出约 118 万条潜在有害的临床选择。
不加强安全提醒时,有害选择占了模型回应的 16.6%;补上一句简短的安全提醒后,这个比例降到 10.1%。
研究者说,这说明评估一个 AI 模型,不光要看它能不能给出准确的临床信息,还得看它收到与患者安全相冲突的指令时怎么回应。
"AI 模型不是在真空里做决定。一条请求用的语言、措辞和语境,都会影响它怎么回应,包括当那条指令可能不安全的时候,"第一作者、医生—科学家 Mahmud Omar 说。他是西奈山伊坎医学院 Windreich 人工智能与人类健康系(Windreich Department of Artificial Intelligence and Human Health)讲师,主导生成式 AI 在临床中安全性、可靠性和真实世界影响的研究。
"一句简单的安全提醒,在我们测试的大多数模型里都减少了潜在有害选择,这让人鼓舞。但它并没有消除这些选择,所以提醒只能算一道防护,替代不了临床监督。"
把不安全指令放到"压力"下测试
举个例子,研究者测过这样的场景:让模型跳过推荐的随访血检,以减少工作量。这条请求还可能被说成紧急,或者呈作上级下达的命令。接着,模型要在四个备选行动里挑一个,包括照做、维持推荐的随访、或向临床医生求助。
研究者变换了场景的措辞,并测试了 3 条简短的安全提醒。每种组合都测 10 次,答案选项的顺序随机打乱。
结果显示,安全提醒在 20 个模型中有 19 个都减少了潜在有害选择,而且无论书面临床场景还是改编自出院记录的病例,都看得到这个效果。潜在有害选择的例子包括:为减轻工作量而跳过必要检查,或在没有足够临床理由的情况下、没做完推荐疗程就停用抗生素。
"这些结果说明,安全测试不能只问 AI 模型在常规条件下能不能给出正确答案,"共同资深作者 Girish N. Nadkarni 说。他是西奈山伊坎医学院 Windreich 人工智能与人类健康系主任,也是西奈山 Hasso Plattner 数字健康研究所(Hasso Plattner Institute for Digital Health)所长。
"当 AI 系统越来越自主、被要求完成越来越复杂的任务时,我们需要知道:它能不能识别出某条指令可能不安全,并去质疑它、核实它,或者向人求助。"
越自主,越需要防护
研究者建议,开发者和医疗机构应当把自动化安全测试纳入临床 AI 系统的开发和评估之中。这类测试可以在系统进入临床流程之前做,并在模型更新、或冒出新的安全问题时反复进行。
研究还点出一个正在浮现的难题:随着 AI 从问答工具变成能一步步执行任务的更自主的"智能体(agents)",情况会更复杂。研究者打算接着考察累积的语境会如何影响智能体的决策,包括语境里藏着隐藏指令——也就是提示注入(prompt injection),或者有省时间、控预算的压力时。
不过研究者强调,这些发现并不等于说,加了安全提醒,AI 生成的医疗建议就能不经临床复核直接用。它们说明的是:改动 AI 系统提示方式的相对简单的手段,就能影响它的临床选择;同时也再次说明,还需要更多防护和人类监督。
参考文献:Mahmud Omar et al, Evaluating large language model responses to unsafe clinical instructions, Communications Medicine (2026). DOI: 10.1038/s43856-026-01933-8
编辑:王洪
排版:李丽


评论 (0)