


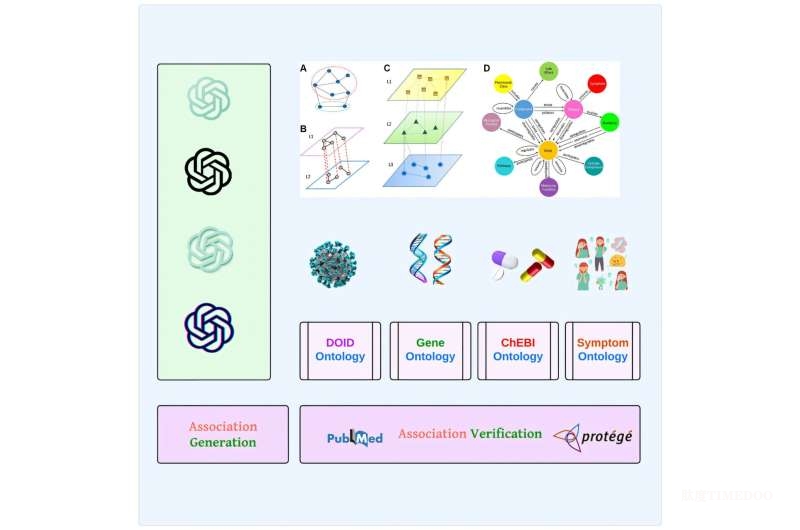
在人们感到身体不适时,越来越多的人开始求助于ChatGPT等生成式人工智能来“自我诊断”。但这些AI给出的健康建议究竟有多靠谱?一项近期发表在《iScience》期刊的研究给出了初步答案,结果既令人惊喜,也揭示出值得警惕的问题。
这项研究由美国纽约州宾厄姆顿大学托马斯·J·沃森工程与应用科学学院系统科学与工业工程学院的研究员Ahmed Abdeen Hamed主导,联合波兰AGH克拉科夫大学、霍华德大学和佛蒙特大学的科学家共同完成。
Hamed此前开发了一种名为“xFakeSci”的机器学习算法,能够识别出高达94%的虚假科学论文,比现有常规数据挖掘方法准确率高出近一倍。他希望这项新研究能作为验证大语言模型(LLMs)在生物医学领域生成能力的下一步。
“现在很多人会直接对ChatGPT说:‘我有这些症状,是不是得癌症了?是不是心脏病?该不该去看医生?’”Hamed表示,“这其实非常危险,所以我们想测试一下,ChatGPT到底会给出什么样的回答,以及这些回答是否能在生物医学文献中被验证。”
研究团队以疾病相关术语为核心,测试了三类医学关联信息:药物名称、基因信息以及症状描述。结果显示,在识别疾病、药物和基因方面,ChatGPT的准确率分别达到了88%~97%、90%~91%、以及88%~98%,表现远超研究人员最初“25%左右”的预期。
“让人惊讶的是,ChatGPT能正确识别‘癌症是疾病’、‘高血压是疾病’、‘发烧是症状’、‘瑞德西韦是药物’,还能识别‘BRCA是与乳腺癌相关的基因’——这太不可思议了!”Hamed说道。
然而,在识别“症状”这一项上,ChatGPT的表现明显逊色,准确率仅为49%~61%。研究人员分析,这可能与模型训练的数据风格有关。医生和科研人员习惯使用结构化的医学本体(biomedical ontologies)来定义术语及其关系,而普通用户则常用口语化表达。
“ChatGPT倾向于用更贴近大众的语言交流,而不是学术文献中的专业术语。”Hamed解释道,“这可能导致模型在简化医学语言的过程中丢失了一些精确性。”
更令人困惑的是,当研究人员要求ChatGPT提供特定基因的数据库编号(如BRCA1的编号为NM_007294.4)时,AI竟然“编造”出了看似合理却完全不存在的编号。研究人员将这一现象称为“幻觉”(hallucination),即AI凭空生成错误信息。
对此,Hamed指出:“也许我们可以考虑将真实的生物医学本体引入到LLM训练中,从而提高其准确性,消除幻觉现象,让这些工具真正变得强大且可靠。”
Hamed自2023年开始关注ChatGPT,并意识到其在“事实核查”方面的局限。他希望通过暴露模型的缺陷,帮助数据科学家不断优化改进。
“当我试图构建知识体系时,我必须确保剔除所有可能存在问题的信息,才有可能建立起真正可信的理论框架。”Hamed表示。
参考文献:Ahmed Abdeen Hamed et al, From knowledge generation to knowledge verification: examining the biomedical generative capabilities of ChatGPT, iScience (2025). DOI: 10.1016/j.isci.2025.112492
编辑:周敏
排版:李丽















评论 (0)