


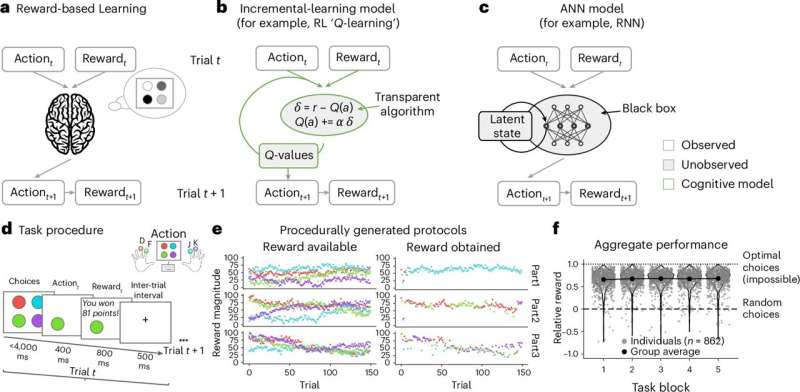
人类如何从过去的经验中学习并做出决策?这不仅是心理学研究了上百年的核心课题,也是人工智能(AI)领域试图模拟的终极目标。尽管强化学习(Reinforcement Learning, RL)算法在机器学习领域取得了巨大成功,但越来越多的证据表明,传统的“裸机”型 RL 模型在解释人类复杂的决策行为时显得过于简化。
近日,来自谷歌DeepMind(Google DeepMind)与牛津大学(University of Oxford)的研究团队在《自然-人类行为》(Nature Human Behavior)上发表研究。他们提出了一种融合深度学习算法与心理学理论的混合建模(Hybrid modeling)新方法,精准捕捉了人类在奖励学习(Reward-based learning)中如何偏离传统算法,为理解人类认知过程提供了更为精确的数学工具。
技术反思:传统强化学习为何在模拟人类时“失准”?
强化学习最初灵感源自神经科学对多巴胺奖赏系统的研究。其核心逻辑在于通过“试错”获取奖励,并根据反馈更新价值函数。
“过去几年的研究通常遵循一个固定的‘配方’:即直接借用在 AI 领域表现出色的算法,测试它能在多大程度上解释人类行为,”该论文的第一作者 Maria K. Eckstein 博士指出,“然而,这种‘拿来主义’的方法往往产生令人沮丧的结果。”
传统 RL 模型往往无法捕捉人类的内部表征(Internal representations)。人类的决策并非简单的数值累加,而是深受复杂的记忆提取偏向、心理预期以及非线性的内部加工逻辑影响。
方法创新:利用 ANNs 自动化探索认知架构
为了修正传统模型的偏差,研究团队引入了人工神经网络来辅助构建结构化的认知架构。
-
自动化模型搜索: 传统上,心理学家需要手动提出假设并修改模型参数,这既耗时且受限于研究者的直觉。本研究利用 ANNs 自动在庞大的函数空间中寻找最佳解决方案,精准勾勒出人类行为偏离传统 RL 模型的具体轨迹。
-
打破样本量限制: 借助 AI 自动化流程,研究人员跳出了传统心理学实验 20-50 人的小样本范式,收集了包含数百至数千名参与者的大规模数据集,从而获得了更强的信号捕获能力。
-
预测力与可解释性的平衡: 混合模型不仅能以神经网络的高精度预测人类的选择,还能保持心理学模型的可解释性,让研究者清晰看到哪些认知过程贡献了特定决策。
核心发现:记忆与内部表征是认知的“拼图碎片”
实验结果表明,相比于纯粹的 RL 算法,整合了人类记忆特性和灵活内部表征的混合模型在预测人类决策方面表现得显著更优。
研究通过数学模型(Mathematical models)精确地界定了传统 RL 在捕捉人类学习时的“失效点”。Eckstein 博士解释称,这种方法让“数据自己说话”,揭示了人类在处理奖励信号时存在着特定的系统性偏差(Biases),这些偏差反映了大脑在处理信息时的独特生物学约束。
临床前景:为神经变性及心境障碍提供“数字表型”
这项研究不仅具有认知科学价值,在临床医学领域也展现出广阔的应用前景。研究团队希望该模型能被应用于临床精神病学研究,以更好地理解以下领域:
-
神经退行性疾病(Neurodegenerative disorders): 如帕金森病中奖赏学习能力的退化。
-
心境障碍(Mood disorders): 抑郁症或焦虑症患者对奖励反馈的感知偏差。
通过这种更贴近人类真实认知的计算模型,科学家可以更深入地分析受损的神经底物(Neural substrate)。Eckstein 总结道:“我们现在拥有了比传统统计学更强大的工具。我希望这种混合模型能成为一把钥匙,通过解释参与者的行为机制,揭示这些疾病底层受损的认知过程。”
参考文献:Maria K. Eckstein et al, Hybrid neural–cognitive models reveal how memory shapes human reward learning, Nature Human Behaviour (2026). DOI: 10.1038/s41562-025-02324-0.
编辑:周敏
排版:李丽















评论 (0)